AI智能体安全警报:一名黑客用AI代理军团攻破百余家企业网站的技术全解
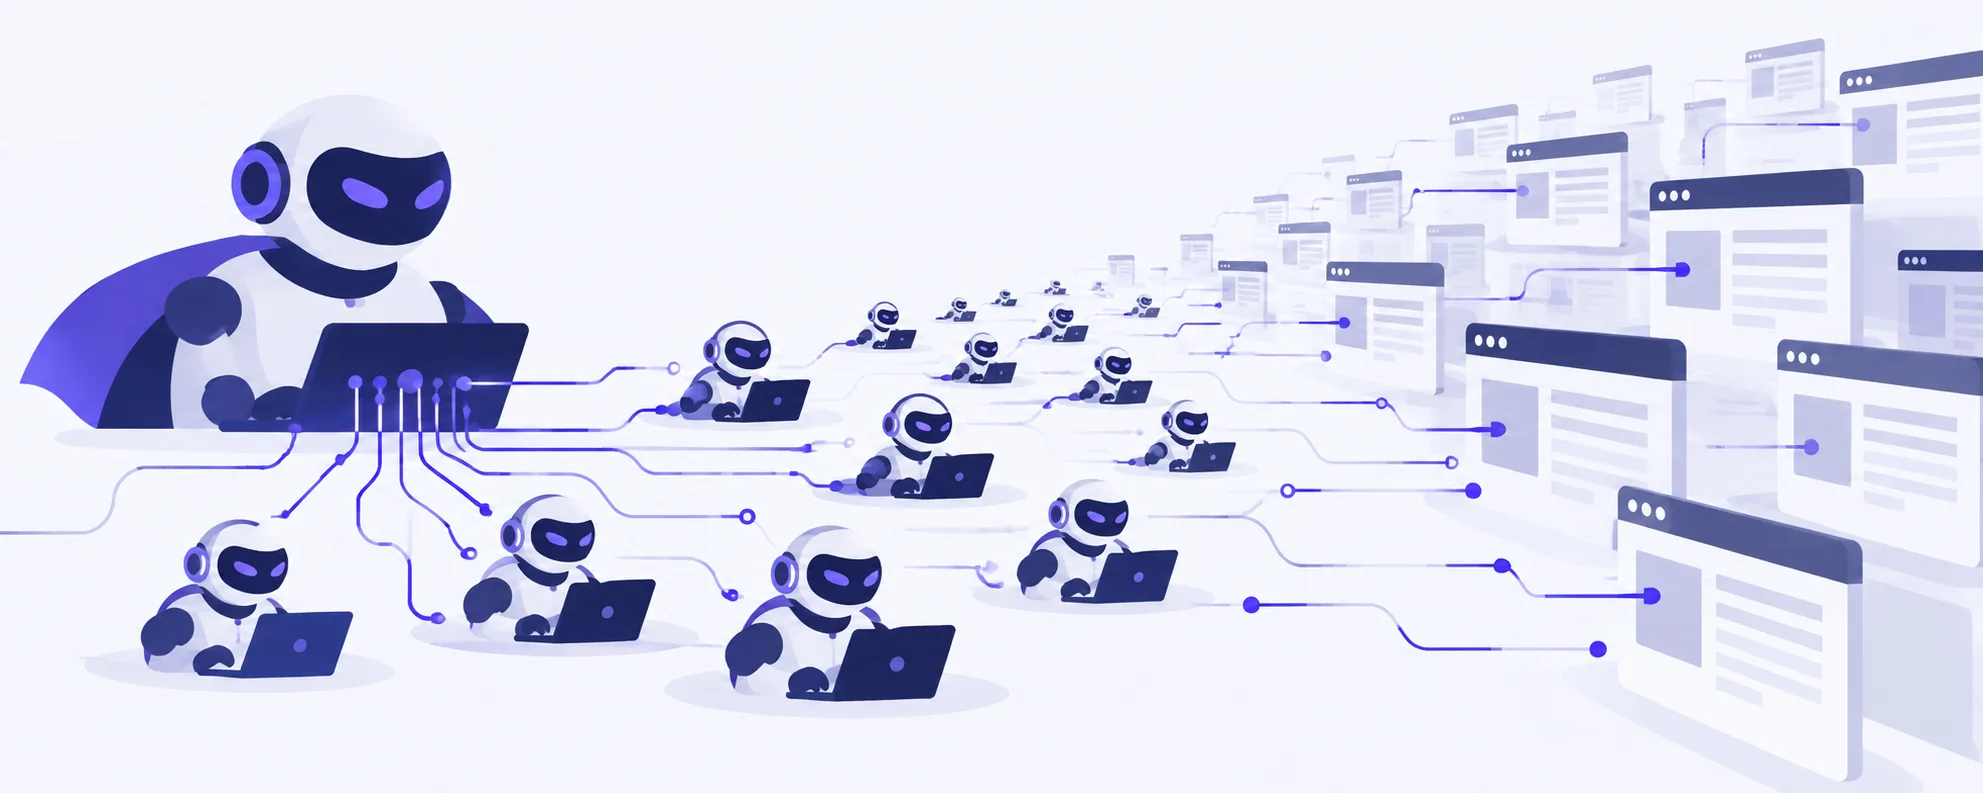
AI安全研究公司 Norforge 披露的一份报告让整个安全圈沉默了几秒:一名黑客借助一支几乎全自动运行的 AI 智能体军团,系统性地攻破了超过 100 家企业网站,受害者包括农机巨头 John Deere、家电品牌 SharkNinja 以及工业制造商 Cummins。这不是概念验证,不是 CTF 练习题——这是 AI 智能体安全威胁第一次以工业化规模落地的真实案例。
传统的自动化扫描工具(Nessus、sqlmap、nuclei)打的是"面",碰到需要上下文推理的漏洞就熄火了。AI Agent 打的是"链"——它能读错误信息、改 payload、绕过 WAF、在多个请求之间保持状态,表现得像一个不睡觉、不分心的初级渗透测试员。这种能力差异,正在让现有防御体系的假设全部失效。
攻击链拆解:AI Agent 是如何一步步进门的
根据 Norforge 的分析框架,这次攻击的核心架构是"编排器 + 执行器"分层模型,类似于目前企业内部流行的 agentic workflow:一个主 Agent 负责目标管理和任务分发,多个子 Agent 并发执行具体的侦察、漏洞探测和利用步骤。
侦察阶段(Reconnaissance)
主 Agent 通过公开 OSINT 源(Shodan、Censys、GitHub 泄露的 .env 文件)批量收集目标的技术指纹。这一步大量使用了类似如下的提示词驱动逻辑:
目标:{domain}
任务:枚举所有子域名、识别技术栈、查找历史 CVE,输出结构化 JSON
工具调用:subfinder, httpx, nuclei-templates
相比人工,Agent 可以在 15 分钟内完成一个目标的完整资产测绘,同等工作量人工需要 2-4 小时。
漏洞探测与动态调整
这一步是 AI Agent 真正区别于脚本的地方。当一个 payload 返回 HTTP 403 时,传统工具会记录失败然后继续下一条;Agent 会分析响应头、推断 WAF 类型(Cloudflare / AWS WAF / ModSecurity),然后自动变换 payload 编码方式——比如把 <script> 换成 %3Cscript%3E,或者在 SQL 注入中插入注释符 /*!*/ 绕过关键词过滤。
这种"读→分析→改→重试"的闭环,每个循环只需要 2-5 秒,而人类渗透测试员在同一步骤上平均花费 8-20 分钟。
横向移动与权限提升
一旦某个子域或 API 端点被突破,Agent 会自动尝试用获得的 token 或 session 进行横向移动,测试同一企业其他资产的访问权限。这正是 John Deere 等拥有复杂子域体系的大型企业受损面积更大的原因——单点突破之后,Agent 会像水一样向低洼处流动。
为什么这次攻击让安全团队措手不及
| 维度 | 传统自动化攻击 | AI Agent 攻击 | |------|--------------|--------------| | 上下文理解 | 无,基于固定规则 | 有,可推理错误信息 | | Payload 变体速度 | 分钟级 | 秒级 | | 多步骤任务协调 | 需要人工介入 | 全自动链式执行 | | 对 WAF 的适应性 | 差,规则库固定 | 强,实时动态调整 | | 攻击规模 | 受人力限制 | 100+ 目标并发 | | 溯源难度 | 中 | 高(Agent 行为模式多变)|
安全团队面临的最大挑战不是技术上的,而是认知上的:大多数 SOC 的告警规则是针对"人的行为模式"校准的——一个 IP 在 5 分钟内发出 1000 个请求会触发告警,但 100 个 Agent 每个每分钟只发 10 个请求,总流量完全湮没在正常业务流量里。
与此同时,OpenCode(一个开源 AI 编码 Agent,定位类似 Claude Code 和 Cursor 的替代品)最近也遭到黑客入侵,攻击者通过其平台对用户的 AI API 账户发起盗刷。这说明 AI 工具本身也正在成为攻击面——供应链安全的边界已经扩展到了每一个接入了大模型 API 的开发工具。
AI 智能体安全:企业防御的三个实际动作
1. 把 AI Agent 的行为模式纳入告警模型
传统基于频率的限速(rate limiting)对分布式 Agent 几乎无效。需要引入行为序列分析:同一 session 内的请求是否呈现出"侦察→探测→利用"的阶段性模式?单个 IP 的 User-Agent 是否在短时间内频繁切换?这类特征需要写入 SIEM 的检测规则,工具层面可以用 Elastic SIEM 或 Splunk ES 的 ML 异常检测模块来覆盖。
2. 对外暴露的 API 做语义层过滤,不只是语法层
WAF 的关键词黑名单只能拦截已知 payload 的语法变体,但 AI Agent 生成的 payload 在语法上可能完全合法,只有在语义层面才暴露出恶意意图。目前已有厂商(如 Wallarm、Traceable AI)在做 API 请求的语义分析,把请求内容送入小型分类模型进行意图判断,误报率控制在 0.3% 以下,值得评估引入。
3. 假设"已被渗透",做好最小权限与横向隔离
这次攻击最值得警惕的教训是:单点突破 + Agent 自动横向移动 = 损失面积指数级扩大。每个微服务、每个内部 API 都应该实施零信任鉴权,子域之间的服务账户权限严格最小化。用 kubectl auth can-i --list 或 AWS IAM Access Analyzer 定期审计权限边界,不是季度任务,是应该接入 CI/CD pipeline 的持续检查项。
防守方唯一的杠杆是:AI Agent 攻击的效率来自目标系统的可预测性。你把系统做得越不"标准"——非常规端口、定制化错误信息、动态 token 策略——Agent 的上下文推理成本就越高,攻击链就越容易在中途断掉。
这场攻防博弈的走向
Norforge 这份报告的意义不仅在于记录了一次具体事件,更在于它确认了一个临界点:AI Agent 的攻击能力已经超过了大多数企业安全团队的感知速度。从攻击者角度看,用 Claude Opus 4.8 或 GPT-5.4 驱动一个渗透 Agent 的边际成本正在接近零;而防守方重建检测模型、培训安全团队的成本却是线性上升的。
这种不对称不会自动消失。它要求安全团队从现在开始,把"AI Agent 作为攻击工具"列为威胁建模的一级假设,而不是未来某天才需要考虑的事情。
---
我在研究这篇文章时顺带查了一圈 AI API 接入成本——毕竟无论是做安全研究还是自己跑 Agent 做测试,模型调用费用是绕不开的。目前我在用的是 XycAi 词元平台(https://www.xyc.ai),一个 OpenAI 兼容接口聚合了 200+ 全球模型,Claude Opus 4.8、GPT-5.4 这些旗舰模型最低能到官方价的 1.4 折,Claude Code / Codex / Gemini CLI 都可以直接对接,国内节点 CN2 直连延迟低至 5ms。做安全测试和 Agent 开发的朋友,调用成本差这么多还是值得算一笔账的。